第34章:常用代码审查 Skill 全景
"代码审查不是审批系统,是质量的最后一道工序。这道工序做得好不好,决定了你是在积累资产,还是在堆积技术债。"
第 25 章讲过 autoreview。Peter Steinberger 把审查做成了一个自动循环:代码改了就跑,该修就修,修完再跑,直到整洁。
autoreview 只是其中一种。写这本书的过程中我一直在想,AI 代码审查这条路上到底有多少种不同的打法。有人查得全,有人查得深,有人想把流程规范化,有人盯着架构腐化的趋势,还有人把 PR 画成一张图。每个工具都有它顺手的场景,也有覆盖不到的地方。
这一章把我用过、研究过的代码审查 Skill 和工具挨个拉出来,一个一节。说清楚它解决什么问题、核心机制是什么、什么时候该用。不排名,不打分,你自己挑。
34.1 /code-review:Matt Pocock 的双轴审查
第 2 章讲过 Matt Pocock 的 Skills 系统。/code-review 是 Engineering 分类下的核心 Skill。v1.1 版本从 in-progress/ 毕业,成熟度比较高。
34.1.1 双轴架构
/code-review 的设计很简单:两个轴,并行跑,不合并。
第一轴是 Standards 轴,查代码写得好不好。命名是否清晰、结构是否合理、有没有坏味道。它自带一份 Fowler 坏味道基线,共十二条:神秘命名、重复代码、特性依恋、数据泥团、基本类型偏执、重复 switch、霰弹式修改、发散式变化、投机性泛型、消息链、中间人、拒绝继承。
这份基线有两个约束。一是仓库自有规范优先。项目的 CONTRIBUTING.md 里写了不同约定的,以项目为准,基线让道。二是所有坏味道都只作为判断上报,不是硬违规。报的是"这里可能有问题",不是"这里错了"。
第二轴是 Spec 轴,查代码做的对不对。有没有忠实实现 issue 或 spec 的要求,有没有偏离需求,有没有漏掉验收条件。这条轴的输入不是代码本身,是变更对应的需求描述和验收标准。
两个轴各自由独立的子 Agent 执行,最后并列呈现结果。Pocock 刻意不让两个轴的结果互相影响排名。Standards 轴发现的问题再多,也不能掩盖 Spec 轴的一条需求遗漏,反过来也一样。分开看才能看到全貌。
34.1.2 在开发流程中的位置
Matt Pocock 的主干流程里,/code-review 是开发循环的收尾:
grill-with-docs → to-spec → to-tickets → implement → code-review → retro
/implement 照着 spec 干活,在约定的接缝处驱动 /tdd。收尾时跑一遍 /code-review 再提交。v1.3 起新增的 /implement-spec(并行版本)收尾也走同样的流程。
审查是开发流程里的一个固定环节,不是事后补救。写完就审,有问题当场修,修完再提交。过不了审查,代码进不了下一个阶段。
34.1.3 什么时候用它
你的项目已经在用 Matt Pocock 的 Skills 体系,/code-review 就是标配,开箱即用。功能开发完、合并之前跑一遍,质量和需求符合性两方面都能覆盖。
它的边界很清楚:基于 diff,增量审查,局部视角。跨模块的架构问题它发现不了,全代码库的腐化趋势它也不会主动扫。这些事交给 /smell 和 Clawpatch。
34.2 Clawpatch:语义级深度审查
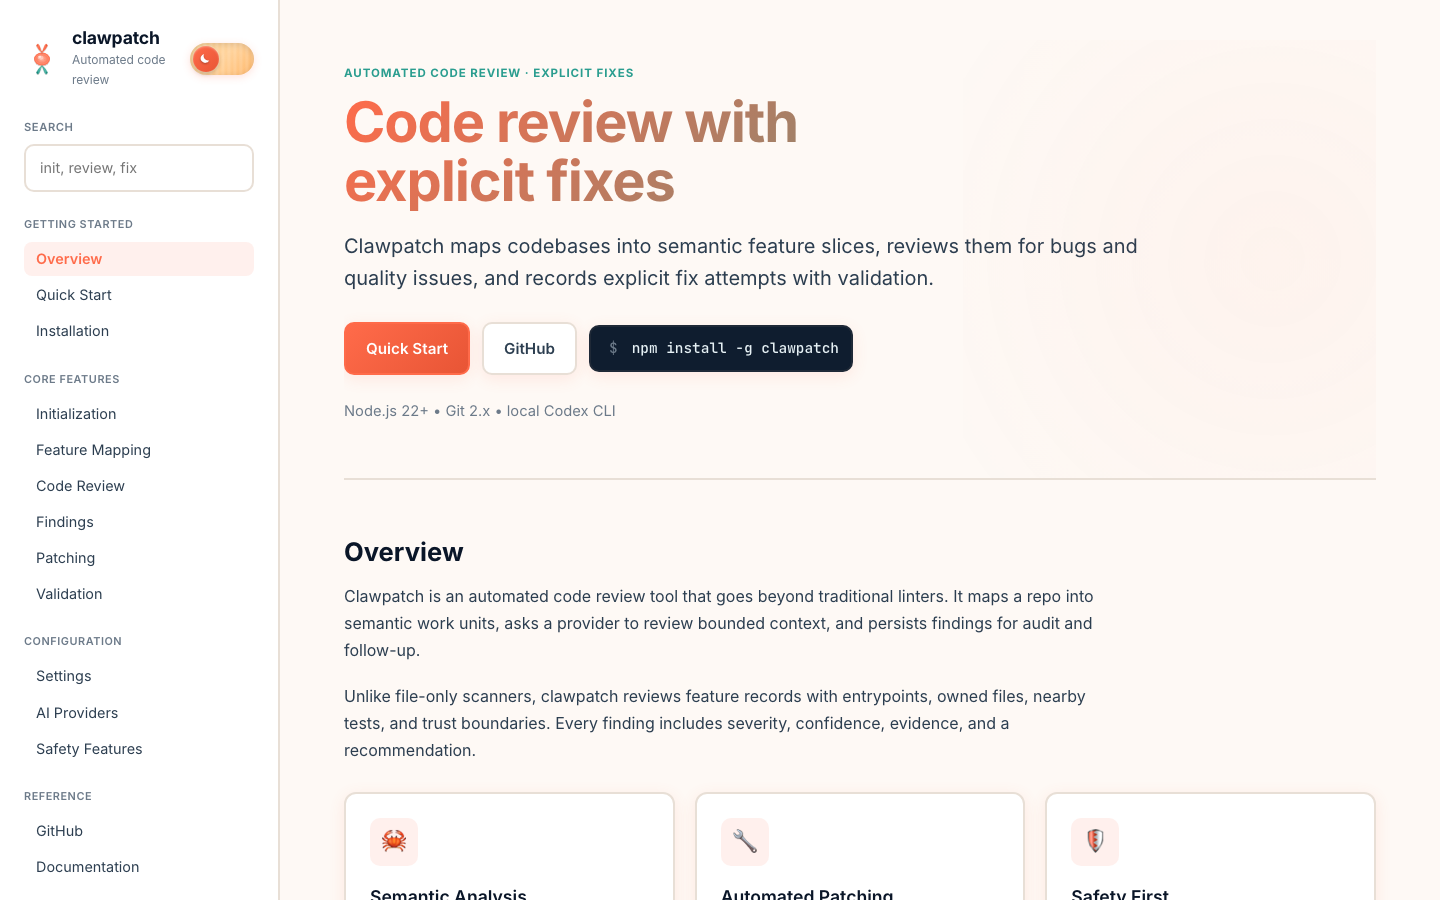
Clawpatch(clawpatch.ai,GitHub: openclaw/clawpatch)也是 Peter Steinberger 做的,MIT 开源。/code-review 逐文件翻 diff,Clawpatch 先把整个仓库读懂,再按语义单元逐个审。
34.2.1 核心创新:语义特征映射
传统的 linter 和 SAST 工具看到的是一棵文件树,一个文件一个文件地扫。发现的问题也都是局部的,比如"这个变量没用"、"这里有 SQL 注入风险"。
Clawpatch 不走这条路。它先用 clawpatch map 命令把整个仓库映射成一组语义特征(semantic features)。每个特征不是一个文件,而是一个完整的功能单元。入口点、归属文件、上下文文件、关联测试,打包在一起。
举个例子。一个 Next.js 的 /api/checkout 路由,它的特征记录包含路由文件本身、引用的 Service 层代码、相关的数据库模型、对应的测试文件。审查的时候,AI 拿到的不是一个孤零零的文件,是这个功能的完整上下文。
这个映射能力是 Clawpatch 最核心的部分。目前它能自动识别的项目类型很全:Node.js/TypeScript(Next.js、React Router、Nx、Turborepo)、Python(Flask、FastAPI、Django)、Go、Rust/Cargo、Java/Kotlin(Gradle、Android 语义角色识别)、C#/.NET(ASP.NET Core、Minimal API)、Ruby/Rails、Elixir/Phoenix、SwiftPM、C/C++、PHP/Laravel。主流技术栈基本都覆盖了。
34.2.2 审查和修复
有了特征映射,clawpatch review 把这些特征单元逐个送给 AI provider 审查。默认用本地 Codex CLI,也支持 ACP 兼容 Agent、Grok Build CLI、OpenCode CLI 这些。
每条 finding 信息很全:分类(bug、security、performance、docs-gap、test-gap、maintainability)、严重程度(critical/high/medium/low)、置信度(high/medium/low)、证据(代码片段、文件位置、推理链)。所有 finding 存在 .clawpatch/findings/ 目录下,持久保存。
Clawpatch 在修复这件事上很保守。clawpatch fix --finding <id> 是一条显式命令,只修你指定的这一条,不会自作主张批量修。
修复过程走完整验证流水线:先格式化(Prettier 之类),再类型检查(tsc --noEmit),然后 lint,最后跑测试。全通过了,修改落在你的工作目录里,等人来审。Clawpatch 不会自动 commit、不会自动 push、不会自动创建 PR,更不会自动合代码。
用 Steinberger 自己的话说,"AI 动手,人类拍板"。效率要,安全底线也不松。
34.2.3 deslopify 模式
deslopify 模式(clawpatch review --mode deslopify)值得单独说一下。
"Slop" 在 AI 编程圈里特指那种"能跑但质量差"的代码。变量名随便起、逻辑能简化但没简化、明显的冗余。2026 年 8 月韦氏词典把 slop 选为年度代表字,也说明业界对 AI 生成代码质量的焦虑有多普遍。
deslopify 模式就是管这个的。它不做严肃的安全或逻辑审查,专门挑可本地验证的代码质量问题。日常跑一下,保持代码库的基本整洁,成本不高。
34.2.4 什么时候用它
中大型项目、模块多、依赖关系复杂的,Clawpatch 价值最大。逐文件审查容易漏掉跨模块的问题,语义特征映射补上了这个缺口。也可以把它当定期审计工具用,每个 sprint 结束跑一次,系统性地摸一摸技术债和安全隐患。
代价是慢。语义级审查要 AI 理解完整上下文,比 diff 级审查慢得多,token 消耗也大。日常每次提交都跑不划算,留给重点功能和定期审计更合适。
34.3 codex-review skill:审查纪律 SOP
Clawpatch 是完整的工具链。codex-review skill(steipete/agent-scripts)更像一份审查流程的标准操作手册。
它就是第 2 章介绍过的那种 skill 文件。YAML frontmatter 加 Markdown 指令集,专门给 Codex CLI 的 codex review 命令用。
34.3.1 核心价值:把纪律写死
这个 skill 的价值不在审查本身(审查是 Codex 做的),而在它定义的纪律。列几条你看看:
- 审查输出只作建议,不能盲信。每条 finding 必须读真实代码路径和相邻文件验证。
- 不切实际的边缘案例、投机性风险,直接拒。不是 AI 报了就要改。
- 修复要小、要精准。不大规模重构,除非它从根上改善了这类 bug。
- 修复后必须重跑测试、重新审查,直到没有 actionable finding。
- 不为了审查 push 代码。审查是本地活动,push 只在用户明确要求时发生。
这些都是常识。但 Agent 真跑审查的时候,该犯的错一个都不会少,要么过度自信,要么过度工程化。codex-review skill 把纪律写死在 skill 文件里,相当于给审查流程焊了一道护栏。
34.3.2 自动模式判断
skill 自带一个 helper 脚本,能自动判断用什么模式审查:
- 当前工作区有未提交修改 →
--uncommitted - 有 PR → 自动抓
gh pr view取 base 分支 - 已经提交到 main →
--commit HEAD
基本零配置。敲一个命令,它自己搞清楚该审什么。
34.3.3 Subagent 模式
还有个务实的设计:建议用 subagent 跑审查。
原因很实际。codex review 输出通常很长,噪音也多,直接在主对话里跑会把上下文淹掉。subagent 只回三类信息:接受的 actionable finding、拒绝的 finding(附一行理由)、需要重跑的测试和文件。主对话保持干净。
34.3.4 什么时候用它
已经在用 Codex CLI 的团队,这个 skill 值得装。它不提供审查引擎,但能把审查流程的信噪比拉高一大截。
也可以跟 Clawpatch 配合着用。Clawpatch 做深度语义审查,codex-review skill 做 closeout 全局检查,互补。
34.4 autoreview:自动化审查循环
第 25 章已经用一整章讲透了 autoreview。这里只做简要回顾,主要是把它放进整个审查生态里,看清楚它和其他工具的位置关系。
34.4.1 核心特征
autoreview 是 Peter Steinberger 开源的,agent-skills 六个 skill 之一。四个要点:
- 自动跑。代码改了就触发,不用手动叫。
- 多引擎。支持 Codex、Claude、Pi、Droid、Copilot、Cursor、OpenCode 七个引擎。可以单引擎,可以双引擎面板,可以自定义评审团,甚至七个引擎一起上。
- Scope Governor。范围控制,防审查跑偏。
- 修复和审查循环。发现问题就修,修完再跑,直到干净。
34.4.2 Scope Governor
autoreview 最有原创性的设计是 Scope Governor,值得再提一遍。
审查开始前先锁定基线:原始需求、目标分支、预期行为、归属边界、改动文件、非测试代码行数。审查回来后,每条发现分三类:
- In-scope blocker:当前 diff 引入的,同一归属边界内,修它不改变任务契约。
- Follow-up:确实是问题,但属于相邻模块或关联 bug,另开任务跟进。
- Stop-and-escalate:需要新协议、新配置、新公共 API、跨归属边界,停,上报。
五条停止条件,触发任何一条就停。小改动变成架构变更了、diff 规模翻了一倍以上且没拿到扩大许可、两轮修复后还没收敛、最佳修复是先定规范契约而不是本地打补丁、修完之后 PR 描述的已经不是同一个行为了。
这个设计对准的是 AI 审查里最头疼的一个问题:范围蔓延。Agent 发现一个问题,觉得可以顺便重构一下,重构到一半要改 API,改 API 又要改配置……回过神来,50 行的 PR 变成 800 行了。Scope Governor 就是堵这个洞的。
34.4.3 在生态中的位置
autoreview 在所有审查工具里自动化程度最高。别的工具是"你跑一下,它给你报告",它是"你写代码,它自动跑,发现问题自动修,修完自动再审"。
但它的定位也很清楚:"收尾关卡,不是审批系统"。它不决定能不能合,只负责找问题、报问题。最终拍板的还是人。
更详细的分析去看第 25 章。
34.5 agent-skills /review:五轴质量门禁
第 16 章讲过 Addy Osmani 的 agent-skills。它不是工具箱,是纪律手册。/review 是七阶段生命周期里的第六阶段:合并前的质量门禁。
34.5.1 五轴审查
/review 从五个方向切:
- 正确性:逻辑对不对、边界条件覆盖了没、错误处理到不到位
- 安全:OWASP Top 10、认证模式、密钥管理、三级边界系统
- 性能:先测量原则、Core Web Vitals、性能分析、bundle 分析
- 可维护性:代码结构、命名、复杂度、技术债
- 代码风格:格式规范、一致性、可读性
严重度分三级:Nit / Optional / FYI。变更粒度控制在 100 行左右。太大了审不动,也容易走神。
34.5.2 四张支撑 Skill
五轴审查不是一张 skill 包打天下。背后是四张各管一摊的 skill:
code-review-and-quality管结构审查,覆盖正确性和可维护性security-and-hardening管安全,覆盖 OWASP Top 10、认证模式、密钥管理、三级边界系统performance-optimization管性能,核心原则是"先测量",不做凭直觉的性能优化code-simplification管代码简化,用 Chesterton's Fence(看不懂为什么存在的东西,先搞清楚再删)和 Rule of 500(超过 500 行的文件必须拆)
四张各管一段,合起来是完整的质量门禁。
34.5.3 反合理化机制
和 agent-skills 里所有 skill 一样,/review 也内置了反合理化机制。Agent 太擅长给自己找借口了:"这个改动太小了不用审"、"就改了个变量名"、"测试都过了肯定没问题"。
/review 的反驳直接写在文件里:所有改动都需要审查。变更越小,审查越容易,越没理由跳过。
七阶段生命周期是强制的。不走过 /review,代码到不了 /ship。你可以快进,但不能跳过。
34.5.4 什么时候用它
已经在 agent-skills 体系里开发的团队,/review 没有理由不用。它是质量的最后一道防线,而且是流程里焊死的。
它的特点是查得最全。五个维度、四张 skill,代码质量的方方面面基本都覆盖了。代价是时间,维度多意味着审查耗时长。适合合并前当正式门禁用,日常快速迭代就别每次都跑了。
34.6 /review-it:Goal Workflow 的审查步骤
第 8 章讲 Goal Workflow。七个斜杠命令,从 PRD 到上线,首尾相连。/review-it 是第四步:代码写完了,过一遍审查。
34.6.1 八个审查方向
/review-it 从八个方向切入,最后按严重度排序:
- 隐藏副作用 — 变更会不会在不显眼的地方产生连锁影响?有没有改共享状态、全局变量、外部依赖的行为?
- 破坏兼容性 — API 签名、数据结构、配置格式、命令行接口改了没?现有调用方会不会受影响?
- 边界情况 — null/空值/空集合、极大极小值、并发/竞态、异常路径,处理了吗?
- 性能风险 — 有没有不必要的循环嵌套、N+1 查询、大对象分配、阻塞 I/O、锁竞争?
- 安全风险 — 注入、越权、敏感信息泄露、不安全的反序列化、依赖版本漏洞?
- 命名误导 — 变量/函数/类型的名字和实际行为对得上吗?有没有名不副实或者语义模糊的?
- 测试不足 — 关键路径、边界条件、错误处理,测试覆盖了吗?现有测试是不是真的在验期望行为?
- 未来维护成本 — 有没有不必要的抽象、重复代码、隐式耦合、难追踪的控制流?
这八个方向是针对中文开发者语境设计的,特别强调隐藏副作用、命名误导、维护成本这些容易被忽略的角度。和 agent-skills 的五轴不是简单的数量差别。切的角度不一样,它更关注变更对整个系统的隐性影响,而不是标准化的质量分类。
34.6.2 审查和修复
/review-it 的流程是:检测变更 → 发现问题 → Agent 修复 → 重新审查 → 直到没 actionable findings。
这个流程和 autoreview 长得像,但控制权不一样。autoreview 是自动跑的,代码改了它就启动。/review-it 是你主动叫的,你觉得差不多了,敲一个 /review-it,它才开始干活。
审查结论是建议,不是命令。"Treat review output as advisory. Never blindly apply it." 每条发现 Agent 都得自己验证:读代码、读依赖、不靠谱的边缘情况拒掉、过度工程化的修改拒掉。
通过审查的标准也不是"零问题",是"没有需要修复的问题"。有些建议你觉得不值得修,说清楚为什么不修,就算通过。
34.6.3 并行关闭与多 Agent 兼容
/review-it 支持五个 Agent:Claude Code、Codex、OpenCode、DeepSeek TUI、Antigravity CLI。不绑死平台,这也是 Goal Workflow 整体的设计思路。
一套审查契约,适配不同的 AI 编码代理。契约写得很明确:审查输出是建议性的、绝不盲目应用、每条发现必须验证、拒绝投机风险和大规模重写、优先小修复、持续跑直到干净。
还有个实用设计叫并行关闭(Parallel Closeout)。格式化先做(因为格式化会改行号),然后测试和审查可以并行。代价是测试可能迫使代码改动,导致审查结果失效。所以如果测试或审查改了代码,就得把受影响的部分重跑一遍,直到都干净。
多 Agent 兼容还附带一个隐性好处:交叉审查。先用 Claude 跑一遍,再用 Codex 跑一遍,两个模型发现的问题经常不一样。各有各的盲区,交叉一下覆盖率就上来了。
34.6.4 什么时候用它
中小团队日常开发,/review-it 够用了。轻、快、配置简单,一个命令就能跑。已经在用 Goal Workflow 其他命令的团队,它是天然的补充,流程一致,体验也一致。
它的定位是"够用就好的轻量审查"。需要工业级深度审查,或者要更全面的覆盖,就得往上加工具。
34.7 /smell:架构坏味道嗅探
/smell 是 Goal Workflow 增强 Skill 包里的,专管架构层面的坏味道。
34.7.1 和代码审查的区别
普通代码审查盯的是代码写得好不好。命名、结构、逻辑、安全,这些都是单文件级别的问题。
/smell 盯的是架构腐化的趋势。模块职责还清楚吗?依赖关系健康吗?有没有循环依赖?是不是在往"大泥球"的方向滑?这些问题,单文件审查发现不了,得站在整个代码库的高度才能看出来。
AI 时代这个问题更突出了。Agent 写代码有个倾向:哪里好写往哪里写,怎么快怎么来。它不会主动考虑架构的长期健康。没人盯着的话,代码库不知不觉就烂掉了。模块边界越来越模糊,依赖关系越来越乱,最后变成谁也不敢动的屎山。
34.7.2 工作方式
/smell 检测八大类、60 多项坏味道:
| 类别 | 代表性坏味道/反模式 |
|---|---|
| 架构级 | Big Ball of Mud、违反层边界、缺失架构、分布式单体、贫血领域模型、过度分层、过度抽象 |
| 耦合 | 循环依赖、内容耦合、公共耦合、Stamp 耦合 |
| 内聚 | 上帝对象、霰弹式修改、特性依恋、数据泥团 |
| 设计 | 泄漏的抽象、静态依赖、违反 SOLID、switch 语句、投机通用性 |
| 代码级 | 发散式变化、数据类、懒惰类、消息链、中间人、重复代码、长方法、长参数列表、魔法数 |
| 测试 | 无测试、测试-实现耦合、慢测试 |
| 命名 | 模糊命名(Manager/Helper/Util 滥用)、不一致命名 |
| 复杂度 | 嵌套循环 O(n²+)、N+1 查询、渲染路径重计算、不必要重计算 |
检测流程分三步,候选和确认发现严格分开: 1. 候选检测:静态模式、文件指标、依赖扫描,只产生候选 2. 上下文验证:读实现和相关调用者;查变更频率、输入规模、框架约束、已有缓解措施 3. 发现确认:根因相同的候选合并,按独立根因计数,不按违反的原则数
每条发现标注证据强度(Measured / Observed / Inferred)和置信度(High / Medium / Low)。严重度分四级:Critical / Warning / Suggestion / 候选需测量。最终输出结构化 Markdown 报告到 tasks/smell-report-[timestamp].md,里面还有模块健康记分卡和重构路线图。
和 /review-it 一样,输出是建议不是命令。接不接受、什么时候修,人来定。架构重构的代价通常不小,优先级和时机都得人来判断。
34.7.3 在开发流程中的位置
/smell 不是每次提交都要跑的检查。它适合定期审计,每个 sprint 结束跑一次,或者每个里程碑跑一次。作用是及时发现架构腐化的苗头,趁问题还小的时候干预,别等烂透了再想办法。
也可以跟 /refactor skill 配合着用。/smell 找问题,/refactor 动手重构,重构完再用 /smell 验证效果。
34.7.4 什么时候用它
代码量到了一定规模,/smell 就有用了。小项目(几千行以内)架构简单,腐化问题不明显。几万行、十几个模块以上,架构坏味道开始积累,这时候它的价值就出来了。
AI 主导开发的项目更应该定期跑。AI 写得快,但不对架构的长期健康负责。定期体检,早发现早干预。
34.8 superpowers 两级审查:角色化审查机制
第 6 章讲 superpowers。它的代码审查不是一个单独的 Skill,是两个 Skill 配合。一个发请求,一个接反馈。
34.8.1 requesting-code-review:发起审查
requesting-code-review 是发起审查的一方。任务完成后自动触发,不用手动叫。
它的审查分两步:
- 规格符合性审查:代码做的事对不对?对照计划和验收标准,逐条核对功能是不是完整、正确。
- 代码质量审查:代码写得好不好?结构、命名、安全、性能、可维护性。
分两步是为了关注点分离。先确认功能对不对,再看代码好不好。功能本身就错了,代码写得再漂亮也白搭。
严重度分三级: - Critical(必须修复):Bug、安全问题、数据丢失风险、功能损坏 → 立即修 - Important(应该修复):架构问题、缺失功能、错误处理差、测试缺口 → 继续前修 - Minor(可改进):代码风格、优化机会、文档润色 → 以后再说
有两个设计细节值得说说。一个是"规格是愿景文档"原则。规格说的是软件必须做什么,但不会枚举每个输入和环境。规格没提到的行为,以"合理人的期望"为判断标准。规格的沉默不是许可。
另一个是"拒绝判断"清单。审查者在结论前把所有考虑过但判定为超出范围的行为列出来,每条带原因。执行者逐条做最终裁定。好处是没有被默默丢掉的东西,审查范围的边界是透明的。
输出格式也固定:先列优点(Strengths),再列问题(Issues 分三级),然后建议(Recommendations),最后评估(Assessment)。能不能合并,一两句话说清楚。优点前置不是客套,是校准机制。赞扬到位了,实施者才会信后面的批评。
34.8.2 receiving-code-review:接收审查
receiving-code-review 是处理审查反馈的一方。它规定了 Agent 接到审查意见后的行为规范:
- 怎么分类反馈(必须改、建议改、可以不改)
- 怎么回应审查意见(逐条回复、说明理由)
- 什么情况下可以拒绝修改建议(违反项目规范、超出当前任务范围)
这个点容易被忽略。很多团队只训练了"写代码的 Agent",没训练"处理审查反馈的 Agent"。结果意见一来,要么全盘接受(不该改的也改了),要么全盘拒绝(该改的也不改)。receiving-code-review 就是干这个的。
34.8.3 子 Agent 审查模式
在 superpowers 的子 Agent 驱动开发模式里,审查也是子 Agent 做的。每个任务完成,主 Agent 派一个审查子 Agent 做两阶段审查。过了就过了,没过就打回给实现子 Agent 改。
子 Agent 审查有个天然优势:上下文干净。审查子 Agent 没参与实现过程,它看到的代码和你看到的一样新鲜。它没有实现者的认知偏差,不会因为"这是我写的"就放松标准。跟人类代码审查里"旁观者清"是一个道理。
34.8.4 什么时候用它
已经在用 superpowers 框架的团队,它的审查是内置的,不用额外加工具。重点是用好 receiving-code-review,确保 Agent 接到审查反馈后处理得当。
它的特点是融入流程。审查不是事后补的环节,是开发流程里自然的一步。任务完了自动审,过了自动进下一阶段。整个流程顺滑,不用人推着走。
34.9 github-deep-review:证据优先的深度审查
github-deep-review 也在 Peter Steinberger 的 agent-scripts 仓库里,跟 codex-review skill 是同门,但定位不一样。codex-review skill 管日常审查的纪律,github-deep-review 管 PR 和 Issue 的深度审查。
它的目标很具体:像 Peter 本人一样审。高置信度、证据优先、代码感知、证据不足的时候愿意说"未证明"。
34.9.1 审查契约:七个必须回答的问题
每次审查必须明确回答七个问题,缺一个都不算完:
- 正在修复的 bug 或行为是什么?
- 能识别根因吗?能的话,代码里的哪里、为什么。不能的话,缺什么证据。
- 对于回归,谁/什么时候引入的?可追溯到具体的 commit 或 PR 吗?
- 当前(或提议的)修复,是读完相邻代码后能找到的最好修复吗?
- 更大规模的重构,会改善正确性、清晰度或未来的可维护性吗?
- 有什么证明:测试、实时复现、CI 检查、文档、依赖源码、已发布行为?
- 还有什么有风险或没验证的?
这七个问题构成了审查的"硬契约"。不是随便列几点就完事,每个问题都得有明确答案。哪怕答案是"无法确定,因为缺 X 证据"。
34.9.2 代码要读多深
github-deep-review 不满足于只读第一个碰到的文件。它要求追踪完整的调用路径:
- 入口点 → 验证/解析 → 路由/分发 → 所有者模块 → 共享辅助 → 持久化/网络/运行时边界
- 配置/schema/文档 → 运行时使用 → 诊断/迁移/修复路径
- 提供者/通道/插件所有者代码 → 通用核心接缝
行为依赖外部库的时候,先读上游文档、源码、类型定义,或者当前包的契约,然后再下判断。源码和可执行证明优先,issue 评论不算数。
这个深度要求跟普通的"扫一眼 diff"有本质区别。普通审查看的是"改了什么",github-deep-review 看的是"这个改动在整条调用链上会产生什么影响"。
34.9.3 出处追踪的严谨性
对于 bug 和回归审查,github-deep-review 做紧凑的出处分析:
- 用
git log -S/-G、git blame、关联 PRs 定位候选 - 说"introduced by"之前,用
git --no-replace-objects cat-file -p <sha>检查原始父提交 - 用
git --no-replace-objects diff验证涉及的行为确实发生了改变 - Blame 的
^sha、porcelainboundary、浅/嫁接历史,都不算引入证明 - 置信度分级:
clear/likely/unknown
这种严谨程度在 AI 审查工具里很少见。大多数工具看到 blame 指向某个 commit 就直接下结论了。github-deep-review 会追问:这个 commit 真的改了行为吗?还是只是重构了代码但行为没变?
34.9.4 什么时候用它
重要 PR 的深度审查、bug 根因分析,这个时候上 github-deep-review。你需要搞清楚一个 bug 的真正根因、谁引入的、最佳修复方案是什么,它能给你比普通审查工具高得多的置信度。
日常小改动别用。深度意味着时间,时间意味着 token 成本。日常用 /review-it 或 /code-review 就够了,关键改动和疑难 bug 再请它出场。
34.10 Jev Review:标量反馈循环
Jev Review 是个 MCP 插件式的审查工具,思路跟前面所有工具都不一样。前面的都是"叙事性审查",给你一份文字报告,列问题,说原因,给建议。Jev Review 是标量反馈循环,给你一组数字分数,你自己诊断,自己改进,自己决定什么时候停。
34.10.1 运行模式
Jev Review 的运行模式是一个循环:
implement → validate → score → inspect → form hypothesis → improve → validate → rescore
第一次评估只是基线,不是结束。重要的任务,每次有意义的变更后都跑一遍,用分数的变动检验改进是不是真的有效。
核心理念是:编码代理对诊断、实现、测试和最终判断拥有全部所有权。Jev 只提供信号,不做决策。代理得自己检查代码、诊断弱点、形成假设、实施改进。
34.10.2 十九个评估方向
Jev Review 从十九个方向评估代码质量,每个方向返回 1-10 分,外加置信度和问题列表:
| 维度 | 说明 |
|---|---|
| correctness | 正确性 |
| cognitiveComplexity | 认知复杂度 |
| readability | 可读性 |
| modularity | 模块化 |
| coupling | 耦合度 |
| changeability | 可变性 |
| abstractionQuality | 抽象质量 |
| projectStructure | 项目结构 |
| duplication | 重复 |
| maintainability | 可维护性 |
| testQuality | 测试质量 |
| reliability | 可靠性 |
| security | 安全性 |
| consistency | 一致性 |
| documentation | 文档 |
| performance | 性能 |
| scalability | 可扩展性 |
| compatibility | 兼容性 |
| observability | 可观测性 |
十九个方向,从正确性一路覆盖到可观测性。方向多不是为了凑数,是为了让你看到分数的结构。不是笼统的"代码质量 7 分",而是"正确性 9 分、可维护性 6 分、可观测性 4 分"。结构清楚了,你才知道该往哪里使劲。
34.10.3 反游戏设计
分数这东西天然有诱惑力。人总想着"刷到 10 分"。Jev Review 明确禁止为了分数做表面改进:
- 投机性架构
- 不必要的抽象
- 无意义的测试或注释
- 机械性的文件拆分
- 范围扩大
- 用户没要求的行为变更
正确性和用户实际需求永远排第一。一个改动提高了模块化分数但降低了正确性分数,那就是赔本买卖。停下来,别为了好看的数字牺牲真实质量。
34.10.4 什么时候用它
迭代式质量提升的时候用 Jev Review 最合适。你有一段代码想系统性地改善质量,但不知道从哪下手。跑一次拿基线分数,对着薄弱的方向逐一改进,每改一次重评一次,用分数变化验证改进是不是真的有效。
也可以当代码库健康度的长期追踪工具用。每个里程碑跑一次,看各方向分数的变化趋势,及时发现正在退化的部分。
34.11 walkthrough:第二阶段走查
walkthrough 也是 Goal Workflow 增强 Skill 包的。严格来说它不是"代码审查",是审查前的准备工作。代理实现和验证完了,生成一份走查文档,让你快速了解改了什么、什么被证明有效,然后你拿着这份文档去做真正的审查。
它模仿的是 Google Antigravity 的 walkthrough plan 模式。代理应该证明变更有效(单元测试加真实行为)、捕获证据、交付审查闸门,而不是扔一堆 diff 过来。
34.11.1 "先说人话"原则
walkthrough 最有辨识度的设计是"先说人话"。文件的第一部分必须是纯语言描述,不允许用技术标识符开头。要求:
- Before / after 的具体描述。从用户或调用者视角看到了什么,不是代码做了什么
- 为什么改。2-3 条大白话
- 读者需要做什么不一样的事
BAD(技术上没错,但读的人解不开)
> 把优先级的写入时机从「即时落库」改为「先返回 draft_id、确认后落库」

GOOD(同一件事)
> 用户改任务优先级时,以前客户端发一次就直接写数据库;现在后端先把可选的优先级算出来
> 让用户挑一个,挑完才写。用户没挑就不写。
这个设计对准的是技术文档的"标识符开头"病。很多文档一上来就是类名、函数名、配置项,不了解上下文的人根本读不懂。walkthrough 强制先讲人话,再讲技术细节。
34.11.2 三级证据出处标签
每个声明都必须标注证据来源的等级:
| 标签 | 含义 | 例子 |
|---|---|---|
| 已实测 | 运行过,有输出 | 95 PASSED / 0 FAILED |
| 代码推断 | 从代码或单测读出来的,没执行 | 「没有优先级时回落 normal」(测试里有对应用例,但没跑) |
| 未验证 | 都不是——而且必须说出来 | 「本机无数据库,服务级行为未在本环境验证」 |
绝不把"代码推断"或"未验证"冒充成"已实测"。这种诚实的标注让审查者一眼就知道哪些结论可靠、哪些是推测,不用自己猜。
34.11.3 审查闸门与爆炸半径
走查文档的最后一部分是审查闸门(Review Gate),供你合并前做 staging-check:
- Diff stat + 文件列表
- 高风险备注(force-push 历史、迁移、配置变更、大规模重构)
- 部署顺序前提。涉及 DDL/迁移/配置项时必须说明:要应用什么、怎么应用、顺序错了会怎样(爆炸半径)
- PR 描述草稿
- 合并清单
"爆炸半径"这个设计尤其值得说。很多文档只会说"记得跑一下 migration",walkthrough 要求说清楚"顺序错了整个服务的任务查询全挂"。用最坏后果驱动审慎决策。
34.11.4 什么时候用它
重要功能的交付前准备,让 Agent 先生成一份 walkthrough 文档。你拿着文档去审,比直接翻 diff 效率高得多。文档已经帮你梳理了变更的逻辑、证据和风险点。
也可以当团队协作的交接工具。你把功能交给同事审查,附一份 walkthrough,同事不用从零开始理解变更,直接从文档切入,审查的效率和质量都更高。
34.12 PR Lens:把 PR 画成一张图
前面十一个工具,输出都是文字:问题列表、修复建议、分数。PR Lens(coldteadotai/pr-lens,MIT 开源)走的是另一条路。它把每个 pull request 画成架构图和数据流图,贴在 PR 的评论里。
它的目标一句话说清:understand a pull request before you read a line of it。先看图,再读代码。开源项目免费,装一个 GitHub App 就能用。
34.12.1 爆炸半径和数据流
PR Lens 的画法分两层。
第一层是架构爆炸半径(blast radius)。它把这个 PR 动到的组件画出来,连上组件之间的调用关系。颜色标出变更:绿色是新增,琥珀色是修改,红色是删除。一张图看明白这次改动波及了哪些组件、怎么连起来的。
第二层是数据流。它把变更画成一条动画序列,一个点沿着箭头一步步走,按实际执行顺序。点任意一条箭头,旁边展开这份 payload:请求和响应。新增的 key 标绿,删掉的 key 标红,颜色和图里一致。
评论还支持嵌套下钻。整个爆炸半径放最上面,下面是新路径,再下面是被废弃的部分,每个 <details> 折叠块都带自己的一张图。每个评论都链到一个交互画布,能缩放、平移、切明暗主题。画布上还能开 walkthrough,一次只亮当前这一步的路由和卡片。
34.12.2 四种跑法
PR Lens 有四种跑法。
第一种是 GitHub App。装到仓库上,每个 PR 贴一条 sticky comment,每次 push 自动更新。不用你出模型 key,最省事。
第二种是 GitHub Action。跑在你自己的 CI 里,用你自己的 key。provider 默认 Gemini,也能换成 OpenAI,或任意讲 /chat/completions 的端点,比如 OpenRouter、DeepSeek。
第三种是 CLI。analyze、render、comment、validate、export 五步,每一步都在你机器上跑。只有 analyze 会调模型,key 从环境变量读,不进命令行。
第四种是给 coding agent 的 skill。npx skills add coldteadotai/pr-lens 装上,跟 agent 说一句"把我刚改的东西画成 PR Lens 图,附到 PR 上",它就自己读 diff、写图、渲染、贴上去。
34.12.3 让 agent 自己写图
第四种方式里有个设计值得单独讲。
普通做法是让模型读 diff,再描述成图。但 agent 往往就是那个模型,它已经理解了自己写的 diff。再花一次 provider key 去"描述"一遍,是浪费。
PR Lens 反了过来。agent 不描述,直接自己写 graph document,然后跑 npx @coldtea/pr-lens-cli validate,让 validator 卡住契约。不满足就一直改,直到契约通过。图里名字标错了,skill 教它去改 .github/pr-lens.yml,而不是改生成出来的 SVG。
.github/pr-lens.yml 是一个 overlay。改名、排除、lane 固定都写在这里。代码挪了、模型重新起名,这份修正一直有效。改动和渲染完全分开,图是可再生的。
34.12.4 什么时候用它
PR Lens 不查代码对不对,它解决的是另一个问题:大 PR 看不懂。几千行 diff 摊在那里,人脑读不进去。先看图,再决定读哪部分代码。
它跟前面十一个工具不冲突,反而互补。审查工具负责挑毛病,PR Lens 负责让你看懂这个 PR 在动什么。可以把它的评论当成 walkthrough(34.11)的可视化版本:一个是文字梳理,一个是图形梳理。
边界也清楚:它不替代审查,只负责把结构画出来。代码写得好不好,还是得靠审查工具和你自己看。
34.13 对比与选择
十二个工具讲完了,放在一起对比一下,帮你挑。
34.13.1 对比表
| Skill | 审查深度 | 审查范围 | 自动化程度 | 覆盖全面性 | 架构视角 | 多引擎 | 典型使用场景 |
|---|---|---|---|---|---|---|---|
/code-review |
中 | Diff 级 | 手动触发 | 双轴(质量+规格) | 无 | 单引擎 | 功能开发收尾 |
| Clawpatch | 深 | 语义特征级 | 手动触发 | 六分类 | 弱 | 多 provider | 深度审计、重点功能 |
| codex-review skill | 中 | Diff 级 | 手动触发 | 依赖 Codex | 无 | 单引擎(Codex) | 规范化审查流程 |
| autoreview | 深 | Diff 级+范围控制 | 全自动 | 依赖引擎 | 无 | 7 引擎 | 持续质量保障 |
agent-skills /review |
深 | Diff 级 | 流程强制 | 五轴 | 弱 | 单引擎 | 合并前质量门禁 |
/review-it |
中 | Diff 级 | 手动触发 | 八方向 | 无 | 5 引擎 | 日常轻量审查 |
/smell |
中 | 全局架构级 | 定期运行 | 架构专项(60+项) | 强 | 单引擎 | 架构健康审计 |
| superpowers 两级审查 | 中 | 任务级 | 自动触发 | 两阶段(规格+质量) | 无 | 单引擎 | 子 Agent 开发流程 |
| github-deep-review | 极深 | PR/Issue 级 | 手动触发 | 证据+出处+最佳修复 | 中 | 单引擎 | 重要 PR 深度审查、bug 根因分析 |
| Jev Review | 中 | 全量代码 | 迭代循环 | 19 方向标量评分 | 中 | 单引擎 | 迭代式质量提升、健康度追踪 |
| walkthrough | — | 变更全景 | 交付前生成 | 证据标注+爆炸半径 | — | 单引擎 | 审查前准备、团队交接 |
| PR Lens | — | PR 全景 | 自动更新 | 架构+数据流可视化 | 强 | 多 provider | 大 PR 可视化理解 |
34.13.2 选型建议
说一下我自己的判断,供你参考。
个人开发者,日常用 Claude Code。从 /review-it 起步就够了,轻量,不折腾。每隔一两个月跑一次 /smell,看看架构有没有在悄悄烂掉。项目进入稳定期、用户量上来了、对质量要求更高的时候,再考虑加 autoreview。别急着上全套,工具是有维护成本的。
中小团队,已经在 Goal Workflow 体系里。/review-it 是标配,没什么好说的。/smell 配合着做定期架构审计,每个 sprint 结束跑一次。重要功能建议交叉审查,Claude 跑一遍,Codex 再跑一遍,两个模型的盲区不一样。花两份钱,但能查到更多问题。值不值看你项目的质量要求。
中大型团队,代码库规模大。Clawpatch 做深度语义审查,agent-skills /review 做合并前门禁,/smell 做架构定期审计。三个工具各管一层,互补。大 PR 频繁的团队再挂一个 PR Lens,先看图再读代码,审查的认知负担小很多。但我得提醒一句:工具越多,落地成本越高。别一上来就全铺开,从一两个开始,用出效果了再加。
追求高程度自动化。autoreview 是首选。配置成代码变更自动触发,发现问题自动修复,修完自动再审。人只看最终报告、做关键决策。这个方案省人力,但对模型和 token 预算要求高,自己权衡。
已经在用 superpowers 框架。两级审查是内置的,不用额外加工具。重点是用好 receiving-code-review。很多团队忽略了这一块,Agent 会不会正确处理审查反馈,对最终质量的影响比审查本身还大。
34.13.3 组合使用的推荐姿势
没有哪个工具能包打天下。实际中通常是组合使用,不同工具管不同层面:
日常开发 → /review-it(轻量快速检查)
    ↓
合并前 → agent-skills /review 或 /code-review(全面质量门禁)
    ↓
大 PR 理解 → PR Lens(先看图,再决定读哪段代码)
    ↓
关键 PR → github-deep-review(证据优先深度审查)
    ↓
定期审计 → Clawpatch(深度语义审查)+ /smell(架构健康度)
    ↓
持续保障 → autoreview(自动化循环)
    ↓
质量追踪 → Jev Review(标量反馈循环)
    ↓
交付准备 → walkthrough(第二阶段走查)
从日常到定期、从局部到全局、从手动到自动,层层递进。不用一下子全装上。按团队规模和项目阶段,从一两个开始,逐步加。
34.14 本章小结
十二个工具讲完了,最后说几句我自己的判断。
这些工具没有高低之分,只有适用场景的不同。你是一个人写代码,还是带一个团队?项目是几千行的小工具还是几十万行的系统?你对质量的要求是"能跑就行"还是"出问题就是事故"?答案不同,选的工具也不一样。
我自己的用法是这样的:日常开发用 /review-it,快;合并前用 agent-skills 的 /review,全;重要功能再跑一遍 Clawpatch,深;每个季度用 /smell 扫一遍架构,看看有没有往屎山滑。够用,不贪多。
工具是手段,不是目的。审查工具再多,最后做决策的还是人。哪些问题要修、哪些可以放、哪些值得重构,都得人来拍板。AI 能帮你找问题,但判断哪些问题值得花时间修,还是得靠你。
下一章讲发布。代码审查过了之后,怎么安全、可靠地把代码送到生产环境。